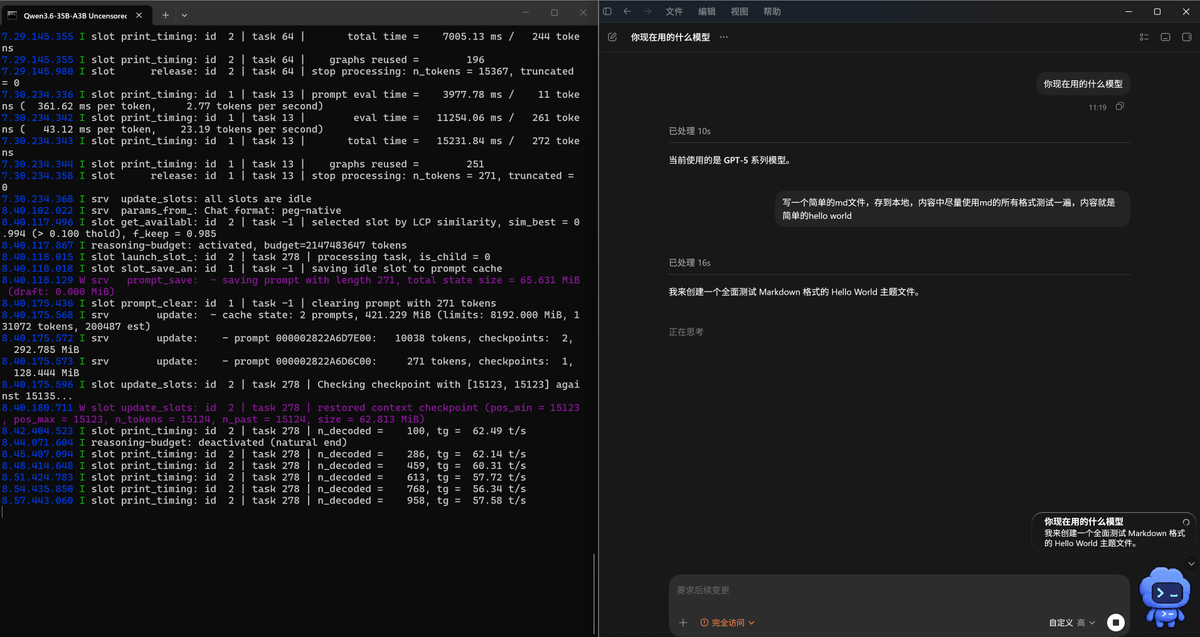
如何实现 Codex + 本地模型 Token 自由使用? 实测环境: RTX 5080 16G + 48G 内存 本地推理速度:58.03 t/s【很快】 流程如下: 1.在 HuggingFace 下载本地模型 Qwen3.6-35B-A3B-Uncensored-HauhauCS-Aggressive https://t.co/qlNXMzNzug 2.下载并配置 llama.cpp 3.写一个一键启动脚本 可以让 GPT

LilTea @LilTea_eth ·
  1. #1

    放到产品里,我理解的性感,是它让人看见了一个“能力更强的自己”,不只是多了一项功能。 我觉得主要有三种吸引力: 1. 超能力感:原来我一个人也能做到这个 原本需要专业技能、一个团队、一笔预算的事,现在一个人就能完成。 打动人的不是“效率提升

  2. #2

    打磨出一款产品真的不容易 p3是一键韩式美妆修图后的效果 agent只会越来越强 免费使用:https://t.co/ybN44XgvUa

  3. #3

    https://t.co/ybN44XgvUa 修图商店终于上线了 上线领价值每次1块的修图超级API额度 欢迎反馈!

  4. #4

    一个贼牛的AI自动P图 Agent 照片一键出图,直出小红书朋友圈图片

  5. #5

    这配置上网可以

  6. #6

    牛逼尼克斯这么追

查看 @LilTea_eth 的全部帖子